

档案数字化做到一半遇到硬骨头:两箱文件里三成是表格——台账、考勤表、库存表,全是扫描件。文字 OCR 好办,表格 OCR 是另一门手艺:表格线认不准,转出来就是一锅粥,单元格全错位。表格识别我把工具挨个跑了一遍,效果差距比文字识别大得多,值得单独写一篇。
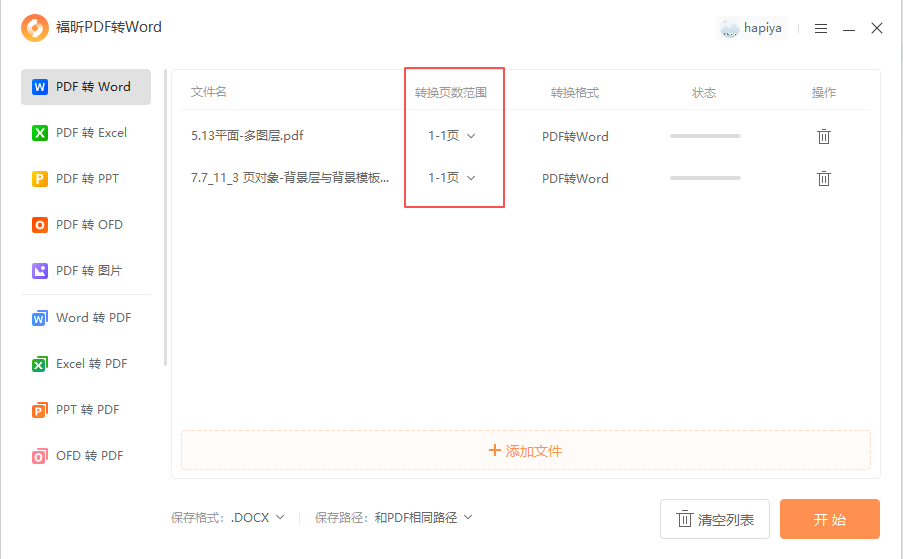
福昕PDF转Word:OCR + 表格转换一条链
它把识别和表格输出串在一起,扫描表格直接出 Excel。
1. 打开软件:启动福昕PDF转Word → 选「PDF转Excel」
2. 导入:把扫描表格 PDF 拖进去,批量支持
3. 选模式:转换设置选「编辑优先」,OCR 自动跑
4. 开始:点「开始转换」,输出 xlsx
规整表格(线完整、拍得正)转出来行列基本对得上,转完数行数核对。线断了的旧表格识别会串行,这种单独走编辑器修。
福昕高级PDF编辑器:先识别,框歪了手动修
它识别完可以手动调整识别框,这是表格场景的独门优势。
1. 打开文件:启动福昕高级PDF编辑器 → 打开扫描表格
2. 识别:「转换」→「识别文本」→「当前文件」→ 选语言
3. 检查框线:识别完查看单元格识别框,被阴影干扰的拖正
4. 转换:「转换」→「到MS Office」→「到Excel」
5. 保存:转完核对行列
我们那批表格里有几张被公章压住了表线,直接转全错位,在编辑器里把识别框手动拖正再转,一次过。手动修框一分钟,省掉 Excel 里重排半小时。
ABBYY FineReader PDF:表格识别的标杆
表格检测是它的看家本领,合并单元格、嵌套表头、跨页表格都扛得住,还会标出存疑单元格让你确认。旧档案、差纸张的识别率明显高一档。贵,表格量大才值。
Adobe Acrobat Pro DC:稳定的主力选手
「扫描和 OCR」后导出 Excel,表格线检测稳,规整表效果好。旧档案错误率上升。订阅贵,速度一般。
iLovePDF:在线识别,操作简单
上传选语言出结果,清晰表格够用。差质量旧表格就别试了,效果一般。文件过云,内部档案慎传。
OnlineOCR.net:免费应急,可选 Excel 输出
网页上传直接选输出 Excel,不用注册,几十页免费。规整表格凑合能用,差表别指望。广告多,下载按钮看准再点。
表格识别还有个「串行」高发位置要重点查:表头。多行表头(比如一级列「上半年」下面套二级列「1月2月」)是识别重灾区,转出来的 Excel 经常把两级表头拍平成一行,后面所有列的归属全乱。核对从表头开始,表头对了,数据行基本不会大错。
合并单元格是表格识别的另一道坎:识别引擎对合并格的处理普遍一般,转出来经常是「左上角有值、其余空格」。用之前要么手动合并回去,要么把值填充到整块区域(Excel 的定位空值+ctrl+enter 一秒填充)。别小看这步,不处理的话筛选和求和全是错的。
表格识别的「五点核对法」流程化:每转完一份,在表格四角和中心各挑一个单元格跟原图对——五点都对,中间错的概率极低。这套动作熟练后一份表格三十秒,比通篇核对省时间,比不核对靠谱。
表格识别的「预处理三件事」再固化一下:去斜(旋转到水平)、去污(裁掉无关边缘)、增强(提高对比度)。手机相册的编辑功能就能做,每张图一分钟。识别工具的能力边界就摆在那,预处理把「差件」变成「中等件」,效果提升比换任何工具都明显。