



两箱档案几百份扫描件要全部 OCR,这种量级再一份份手动识别,做人做成机器。批量 OCR 的核心是三件事:队列稳定不崩、语言设置一次到位、输出命名不乱。工具筛选和流程细节如下,这套流程我们跑完了整箱档案,可直接抄。
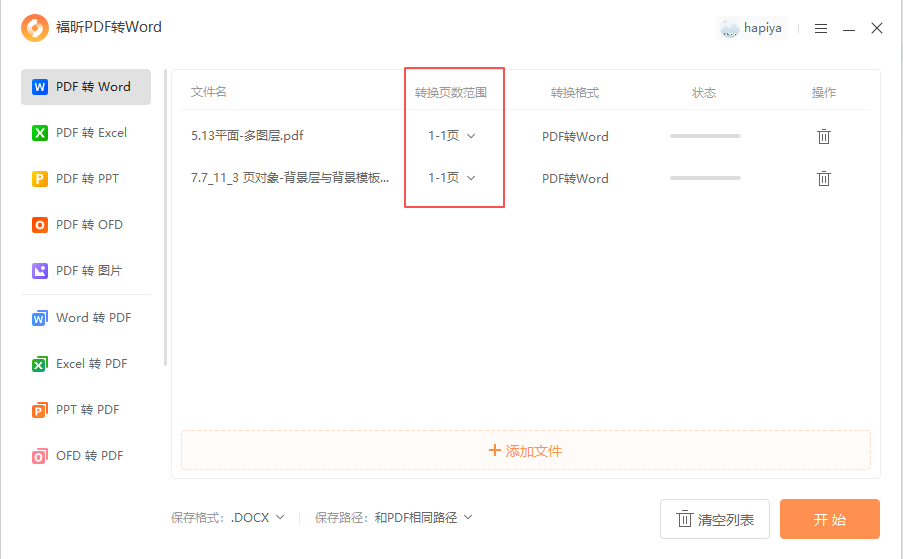
福昕PDF转Word:整批进队列,转完即用
批量转换队列是它的主场,OCR 自动串联。
1. 打开软件:启动福昕PDF转Word → 选「PDF转Word」
2. 批量导入:全选扫描件拖进去,或拖文件夹
3. 统一设置:模式全选「编辑优先」,语言一次设对
4. 设输出:统一目录、按原文件名输出
5. 开始:点「开始转换」,队列自己跑
先拿十份试跑验证设置,没问题再上全量——这条铁律能救你几百份的错误返工。几百份我们分了三个批次跑,每批之间检查一次输出目录,崩了能从断点续。
福昕高级PDF编辑器:多文件识别队列,档案室标配
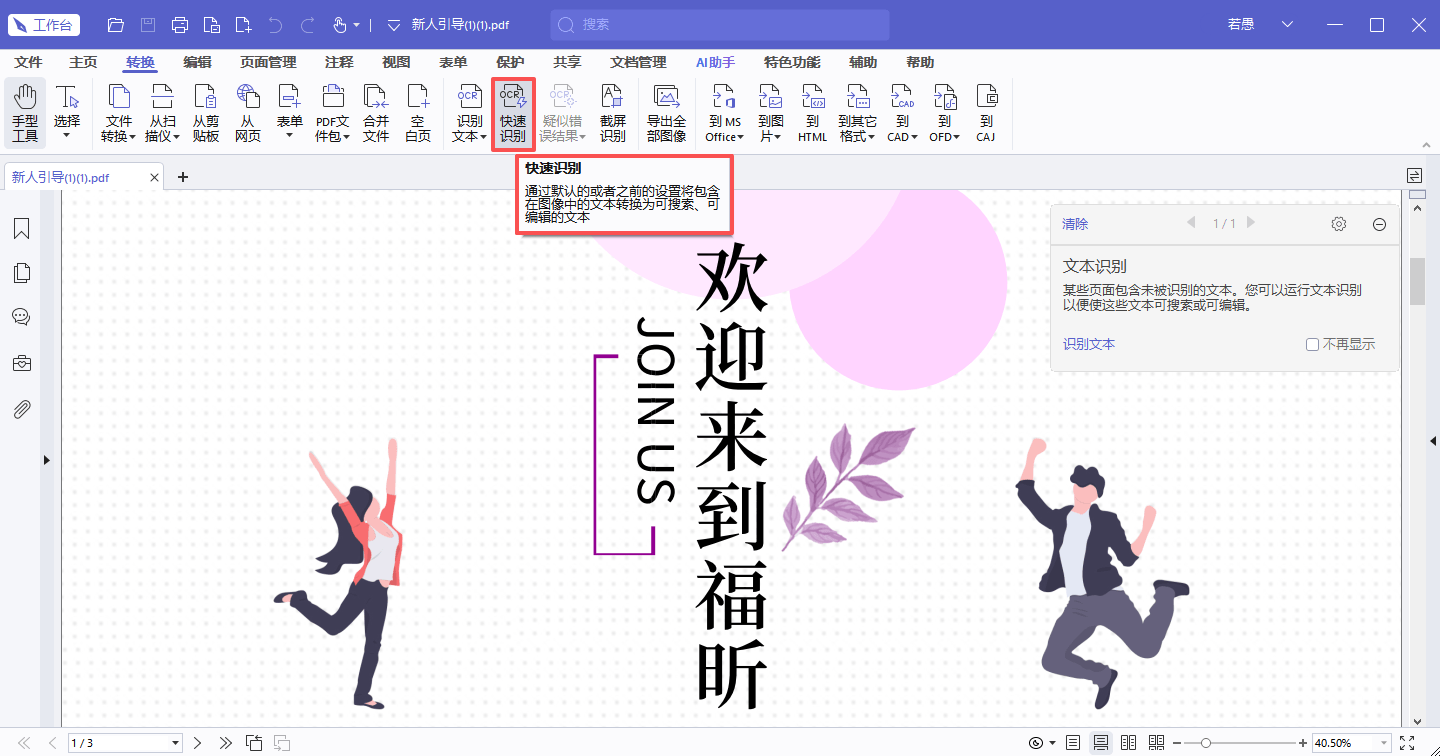
目标若是「可搜索 PDF」而非 Word,它的批量识别入口更合适。
1. 进队列:「转换」→「识别文本」→「多个文件」
2. 添加文件:整批扫描件加入列表
3. 统一设置:全选后一次设语言和输出类型,检索场景选「可搜索的图像文本」
4. 设输出:目录和命名规则统一
5. 执行:点「确定」,自动排队跑,跑完去干别的
它跑完在指定目录生成新文件,原件不动,出问题随时重跑单份。两箱档案我们分两个下午跑完,全程没守着。
ABBYY FineReader PDF:自动化任务,长期滚动归档
「自动化任务」可以监视文件夹,新扫描件进来自动 OCR 输出,适合常年有新增档案的岗位。识别质量也是第一档。贵,量大摊薄。
Adobe Acrobat Pro DC:动作向导批处理
「动作向导」配置「OCR → 保存」流程挂批量,设置一次长期用。稳但慢,订阅贵。
iLovePDF:在线批量,小量方便
多份一起传,打包下载,几十份以内顺手。几百份上传下载都吃力,免费额度更扛不住。档案过云多数单位不允许,本地工具稳。
PDF24 Tools:免费跑量兜底
桌面版批量不限次、离线处理,预算为零的批量场景可行。识别质量对清晰件够用,差件一般。
批量 OCR 还有个时间安排技巧:放在下班前挂队列,第二天早上收结果。几百页的识别任务跑三四个小时很正常,占着白天电脑卡成幻灯片不划算。挂队列前确认电脑设置了「不休眠」,别跑一半睡了。
输出命名规则展开说一下:推荐「原文件名_ocr」这种后缀式命名,跟原件一眼对应,排序也挨着。别用「output_001」这种流水号——几百个文件你根本不知道哪个是哪个。命名这事在转换设置里配好一次,后面全自动,前期一分钟,后期省一天。
批量 OCR 的「失败重试」也配置好:队列里偶尔有一两份报错,跑完统一看失败清单,把失败文件单独再拖一轮——很多报错是偶发的(内存、超时),第二遍就过了。两遍还失败的才需要人工诊断,别第一遍就慌。
批量任务的「硬件准备」也说一句:大批量识别吃内存,转换前把浏览器几十个标签页关一关、别同时跑网盘同步——腾出来的内存都给队列。经验上,同样的任务,清理过后台能快三分之一。磨刀不误砍柴工,说的就是这种事。

