


扫一扫添加福昕福利官

做产品手册那次,我把扫描件拿去ocr识别,结果文字是认出来了,版面全散了——图文叠在一起,分栏也串成了一长条,还得重新排一遍,比重做还累。后来才明白,OCR 的输出模式很关键,有的会把整页重排,有的保留原始外观只加一层隐藏文字。下面 7 款我按「识完不乱版」来排,福昕两款写全步骤。
1. 打开扫描件:启动福昕PDF编辑器,点【打开文件】导入文档。
2. 点识别文本:右上角弹出提示后,点【识别文本】。
3. 想保留原样就选【可搜索的图像文本】:这个模式保留原始扫描图像,在上面加一层可搜索文字,看起来完全没变,也不会重排。
4. 想要外观不变且清晰,选【可搜索的图形文本(原始图像)】:同样不打乱版面。
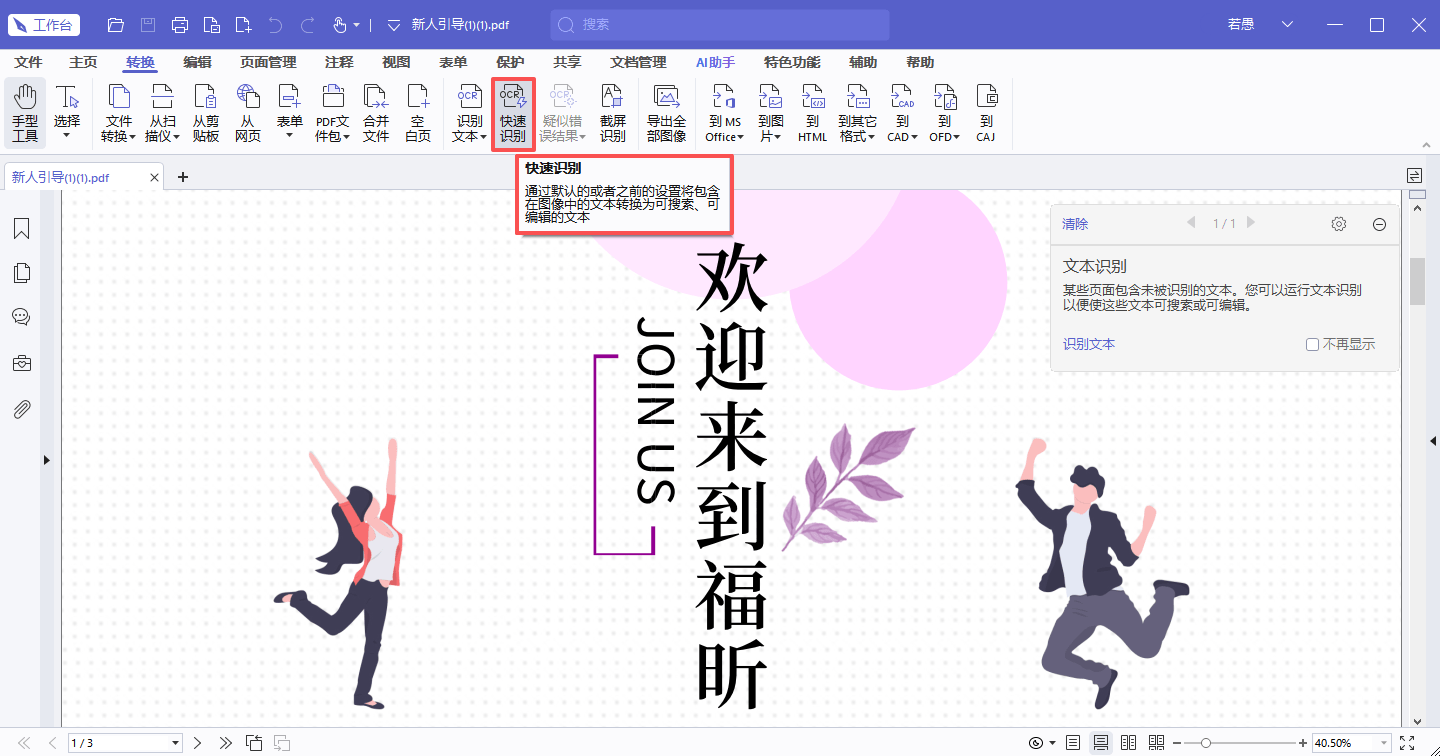
5. 后续要改字才选【可编辑的文本】:这个模式会把内容转成可编辑对象,排版有微调是正常的,但能直接改字。
6. 勾语言:手册里中英文都有就把两种都勾上,识别准确度高一些。
7. 开始识别:点【确定】等进度走完。
8. 检查版面:识别完后翻一遍,图文位置和原来一致就没问题,另存一份留着。
1. 打开文件:用福昕高级PDF编辑器打开扫描 PDF。
2. 点 OCR 按钮:工具栏里找到【OCR】。
3. 自动检测语言:软件自动判断语种,中英混排也能处理,确认后继续。
4. 优先用任意区域识别:只想认某一段就用【任意区域识别】框住目标,不会动到整页版面。
5. 整页识别时心里有数:整页跑会重排内容,图文混排的手册要提前有准备,识别后可能需要微调。
6. 结果单独处理:识别结果窗口里的文字可以直接复制出去,不一定非要覆盖原版面。
7. 另存保护原件:识别完一定另存新文件,原始扫描件留着当底本。
iLovePDF 的 OCR 输出的是可搜索 PDF,原始图像基本保留,版面不会被打乱,这点对图文手册比较友好。操作是上传 → 选语言 → 下载三步。它不支持后续的精细编辑,识完想改字还得换工具。文件要过网络,涉密手册慎用,免费版有大小限制。
Smallpdf 识别完能直接转成 Word 文档,好处是后续调整版面方便,坏处是转格式本身就可能带来排版偏移,图文混排的手册会有点错位。它的识别对普通文档够用,界面引导清楚。免费版每天有任务次数上限。
Acrobat 在保留原始版面这块做得最好,识别后图文位置、分栏结构基本能维持原样,对排版讲究的产品册、报告很关键。它的识别引擎对复杂版面容忍度高,代价是订阅贵、软件重,日常简单文档用有点浪费。
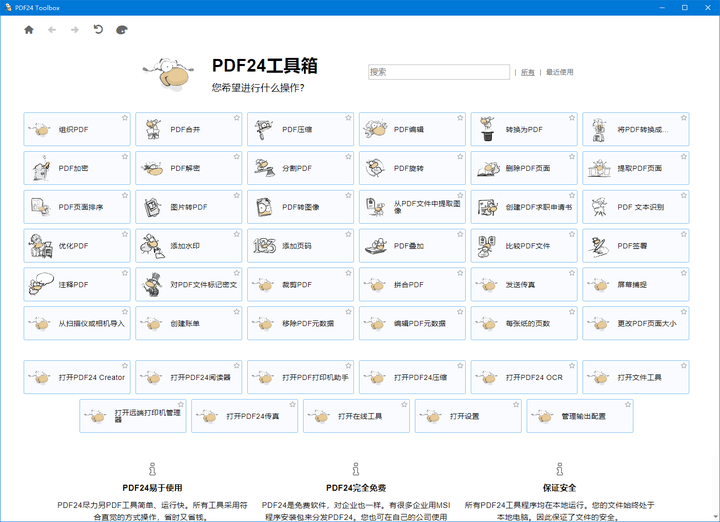
PDF24 桌面版的 OCR 输出的是可搜索 PDF,原始扫描图像保留,版面不会被重排,而且是免费离线处理,文件不出本地。它处理速度稍慢,页数多的手册要等一会儿,但作为保留原样的方案很稳。
Sejda 的 OCR 输出可搜索 PDF,对版面影响不大,操作界面也比较清爽。免费版对页数和文件大小卡得紧,几十页的产品册处理不了,只能先拆分再分批识别。
想「识完不乱版」,最稳的一条是:只要能选输出模式,就别选会把内容重排成可编辑对象的那种,选保留原始图像的模式,版面百分之百不变,还能搜索复制。真要改里面的字,再单独拿一小块区域去识别,局部改动比整页重排安全得多。
版权声明:除非特别标注,否则均为本站原创文章,转载时请以链接形式注明文章出处。
政企
合作

了解平台产品

预约产品演示

申请产品试用

定制合作方案
福昕
福利官
扫一扫添加福昕福利官
了解平台产品
预约产品演示
申请产品试用
定制合作方案

添加福昕福利官
微信扫码
免费获取合作方案和报价


