ofd转pdf转出来是空的?页面缺失的原因排查路线


政务窗口的朋友碰上过怪事:一份红头文件的ofd转成pdf,打开一看中间空了三页,正文明明是有的,就是怎么翻都翻不到。ofd转PDF转出来是空白页或缺页,听着吓人,排查起来其实有清晰的路线——因为空页的原因集中在三个地方:源文件本身、转换工具的渲染能力、字体资源的缺失。
同事第一次遇到中间空三页的pdf,第一反应是"转换坏了,重转",折腾两轮结果一样,差点把源文件也怀疑了。后来打开原ofd一看,红头文件本身在那一节就是空白过渡页。这种乌龙很典型:先怀疑工具,最后发现是源文件本来的样子。
我把几款工具拿来转过同一批含复杂版式的ofd,把空页的成因和排查动作一次讲清,照着走基本十分钟内能定位。空页这种事,宁可多看一眼源文件,也别急着怪工具。
福昕PDF转Word:批量转换 + 空页排查一套走
步骤:
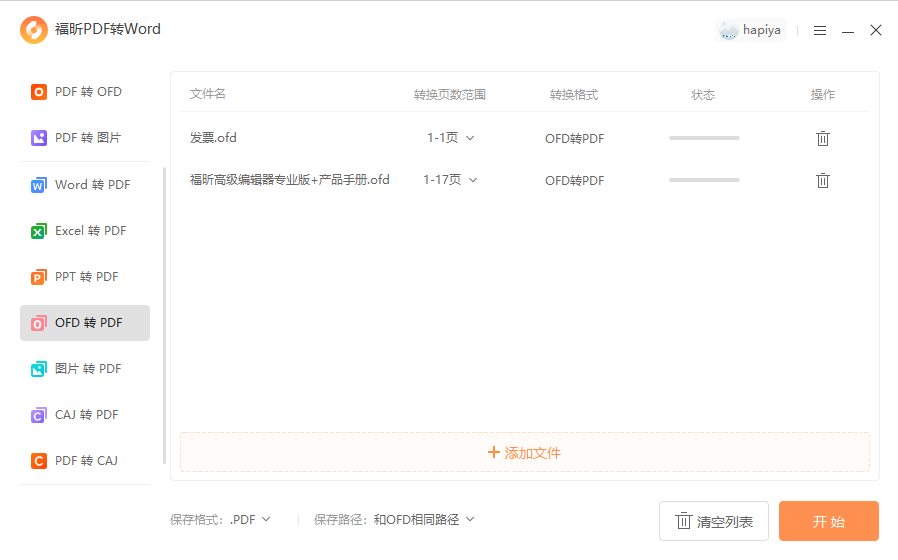
1. 打开福昕PDF转Word,左侧点【OFD转PDF】,文件拖入,先在列表里确认源文件状态正常;
2. 【输出设置】选好目录,点【开始转换】;
3. 转完逐页翻看pdf,标记出空白页和缺页的位置;
4. 空白页出现在文件中部:多半是源ofd里本来就是空白页(红头文件常见),用福昕PDF阅读器打开原ofd核对,原文件有的空页保留即可,纠结的话用编辑器删掉空页;
5. 整页内容缺失:怀疑字体缺失或版式元素渲染失败,换一款工具重转该文件对比,哪款转得全用哪款;
6. 批量场景下把异常文件单独归组,按上面两条分别处理,别整批重转浪费时间。转换工具的字体覆盖能力还跟系统字体库有关,同一个工具换台电脑结果可能不同。批量转换政企文件前,先在目标电脑上拿最复杂的文件试转一份,确认字体渲染完整再跑整批,这个习惯能避开大部分缺字问题。
福昕PDF阅读器:先核对源文件,空页问题现原形
排查第一步永远是打开原ofd核对:用福昕PDF阅读器免费打开,翻到pdf里空白的位置,看原文件这里是不是也空。原文件空就是源文件的事,原文件不空才是转换环节的事。这一步能砍掉一半的无效排查。
数科OFD格式转换平台(ofd.cn):官方系渲染兜底
数科平台对国标OFD的渲染最全,字体和版式元素覆盖广。本地工具转出来缺页的文件,拿它重转一次对比,缺的内容补回来了就说明是渲染覆盖问题。在线方式单份处理,涉密文件别传。
iLoveOFD:换条渲染路线验证
iLoveOFD免登录直接转,当第二条渲染路线用:一款工具缺页、另一款不缺,基本能锁定问题在特定渲染实现上。它功能单纯,验证成本低。
HiDocs文档服务平台:批量场景的对比路线
HiDocs批量转换,适合整批文件出现同类缺页时拿一部分样本去对比验证。转完打包下载,排查效率高。同样别传涉密文件。
WPS Office:本地第三条路线
WPS能打开ofd,也可以作为本地验证的第三条路。它对特殊版式的渲染有自己的实现,三方对比下来,缺页原因基本能定位到工具或字体层面。
字体缺失还有个肉眼判断法:转出来的pdf里某些字变成方块或者问号,基本就是渲染时字体没找到。这种别反复重转,先把工具的字体嵌入选项打开,或者换渲染覆盖更全的工具。政企文件用的字体库五花八门,转换工具的字体覆盖能力,平时拿一份最复杂的文件试一下就有底了。
空页排查的口诀:先看源文件有没有,再换工具重转对比,最后查字体资源。三步走完,空页和缺页的锅都能甩到该背的人身上。