扫描版pdf转excel怎么识别?OCR和人工核对的分工


供应商发来的报价单、老系统导出的对账单,很多是扫描版pdf——整页就是一张图,选中文字都选不中。这种文件转excel,靠的是OCR识别,而OCR的准确率决定了你是「转完直接用」还是「核对到眼瞎」。这篇讲扫描版转excel的正确姿势,OCR和人工核对怎么分工。
福昕PDF转Word:带OCR通道,扫描件也能转
扫描件转换我用福昕PDF转Word,它的转换通道支持扫描件OCR识别,把图片里的表格还原成可编辑的excel。操作六步:
1. 打开软件,首页点【PDF转Excel】;
2. 扫描版pdf拖进列表;
3. 把OCR识别打开(关键一步,不开就是空表格);
4. 识别语种选中文简体,语种错了识别出来全是乱码;
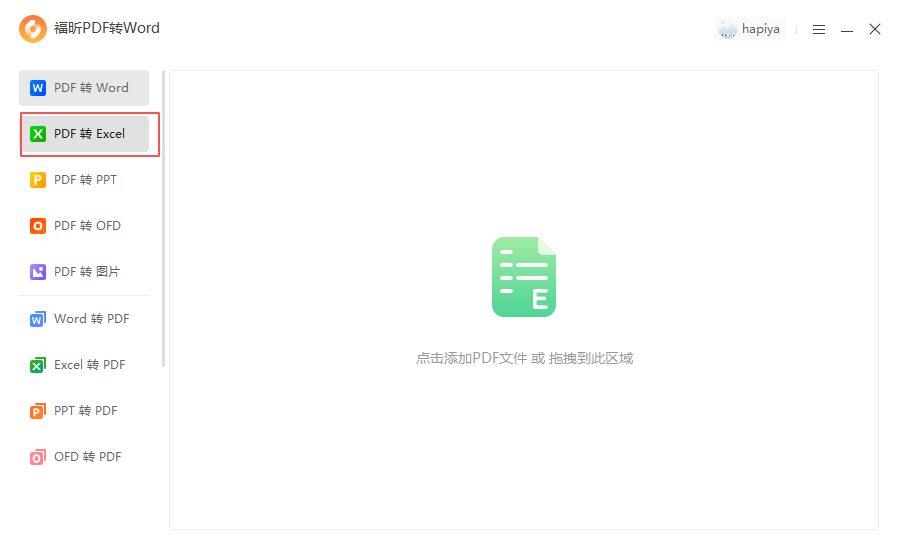
5. 设输出目录,点开始转换,扫描件比普通文件慢,耐心等;
6. 转完逐列核对,重点看数字。
识别质量跟源图清晰度强相关:300dpi左右的清晰扫描件,规整表格的识别率能到九成以上;斜的、糊的、手写的就难说了。所以转之前先看源文件质量,太糊的先处理图片再转。它识别完的表格结构保留得不错,行列是齐的,核对起来有基准可对。
人工核对的分工原则给你:金额、数量、日期这类要参与计算的列,逐个核对,一个都不能放;名称、备注类列抽查就行;表头识别错了的顺手改掉。核对时把原pdf和excel并排开,滚轮同步往下走,一小时能对完几十页。
在线识别的语种选项记得手动选,自动检测对纯表格页面偶尔判断错,语种错了识别出来全是乱码。
福昕PDF365:在线OCR,试水快
福昕旗下的在线站,pdf转excel支持扫描件识别,上传转完下载。先转一份验证识别率,效果可以再批量走客户端,试水流程用它顺手。
iLovePDF:在线OCR可用
PDF to Excel对扫描件会自动走OCR流程,常规清晰扫描件识别可以。复杂表格的行列偶尔错位,核对时注意。免费版有大小限制。
Smallpdf:小文件应急
扫描件也能转,识别质量中规中矩,免费次数有限,应急转一两份可以。
Adobe Acrobat Pro DC:OCR的天花板
Acrobat的OCR识别引擎是业界标杆,模糊扫描件的识别率明显高一截,表格结构还原也最稳。预算够、扫描件量大的财务岗,配它最省核对时间。
OCR核对的高效姿势再说下:excel里用「错误检查」圈出疑似文本型的数字(左对齐的),锁定问题区域集中核对,比全表肉眼扫快三倍。多页连续扫描件的分页核对别省:扫描时页面边缘的字容易被裁一半,转完翻每页首尾行,缺字的从原pdf截图补,这类损伤OCR不报错,只能人工发现。识别率低于八成的文件别硬用,重新扫一遍比反复调参省时间,源头比参数重要。
OCR核对的高效姿势:excel「错误检查」圈出疑似文本型数字(左对齐的),集中核对比全表肉眼扫快三倍。多页扫描件翻每页首尾行,缺字的从原pdf截图补,这类损伤OCR不报错只能人工发现。识别率低于八成的别硬用,重新扫一遍比调参省时间。
期望值先摆正:OCR不是百分百准确,任何工具都做不到。正确的工作流是「OCR出九成+人工核最后一成」,别指望转完直接交付。源文件质量差的话,识别率断崖下跌,先用修图工具把扫描件摆正、调对比度,再喂给OCR,这一步比换任何工具都管用。扫描件转excel,核对永远省不掉,省的只是核对的工作量。