
 免费下载

 2026-09-19 15:00:24

上周整理培训材料,手上是打印店扫的30页讲义,图片格式,一页大概两兆。我想着直接转成PPT省事,转完打开一看,每页都是一张完整的图,鼠标点上去只有一个大边框,一个字都改不了。当时还以为是工具不行,换了两个在线的,结果完全一样。
后来才想明白:扫描件里根本没有「文字」这个东西,它只是一张照片。转换工具看到的是像素,不是字符,它唯一能做的就是给这张照片在幻灯片上找个位置。所以扫描件转PPT这件事,从来不是换工具的问题,是顺序的问题——必须先把照片里的字识别出来,再谈转换。
下面7款我按「能不能自己完成识别」来排。有的能一条龙做完,有的只能做一半,还有的干脆做不了,得老实换工具。
1. 福昕PDF阅读器:没有OCR,扫描件转出来就是整页图
先说实话:这个版本没有OCR能力,我在官方功能说明里也查不到对应的菜单级出处。所以扫描件它当然能转——「转换」→「PDF转PPT」,一页对应一张幻灯片,注册用户免费前5页,本地跑不上传——但转出来的每页都是一整张图,文字改不了,图表也拆不开。它能干的是文字版PDF的转换,扫描件得先去别处补识别,或者直接跳到第2款一步做完。
第1步,先确认有没有文字层:打开PDF拖选一行字,选不中就是扫描件,别急着转。
第2步,文字版走转换入口:「转换」→「PDF转PPT」,部分版本显示在「特色功能」下,以实际界面为准。

第3步,导入并设页面范围:跳转页面里导入PDF,先转前几页看效果。
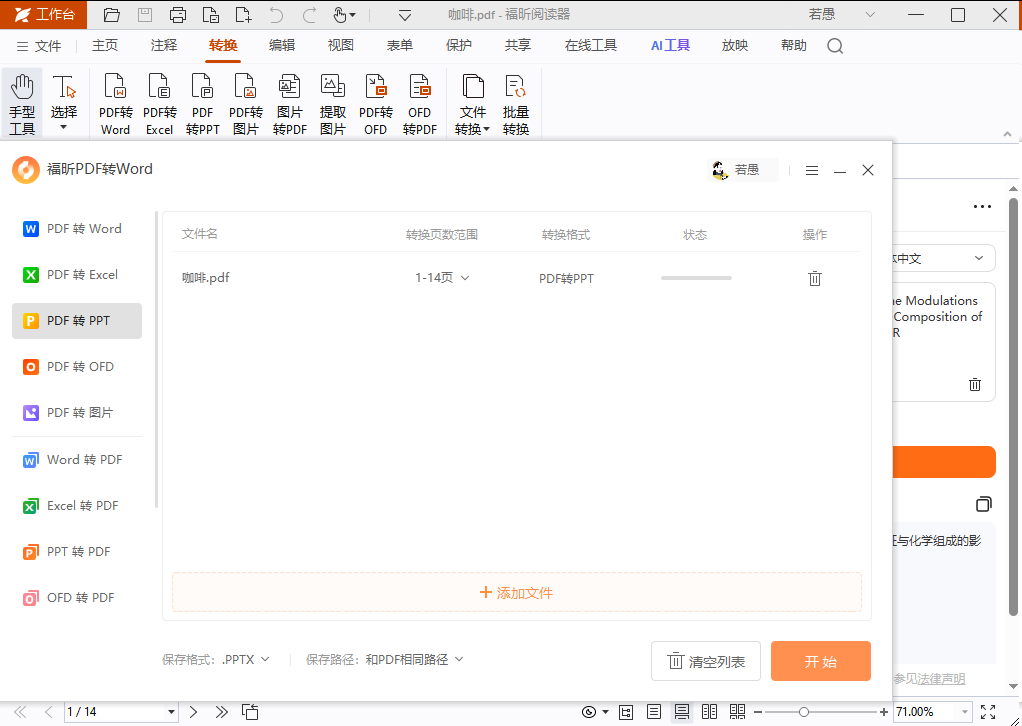
第4步,设保存路径并点开始:选好文件夹,等进度条走完。
第5步,检查输出形态:整页一个大边框说明是图片,需要换工具补识别,别在这儿耗时间。
2. 福昕PDF编辑器:识别加转换,一个软件内做完
它是这一组里最省事的一条路线:同一个软件里先做OCR,再转PowerPoint,不用把文件传来传去。识别路径是「转换」→「识别文本」→「当前文件」,输出选「可编辑文本」,这一步会把识别出来的文字层压回原文件;然后「转换」→「到MS Office」→「到PowerPoint」导出,出来的字就能改了。全程本地处理,处理证照、合同这类材料比较放心。识别完记得扫一遍,中文混排里的数字和英文单词最容易认错。
第1步,打开扫描件走识别:「转换」→「OCR识别文本」→「当前文件」。
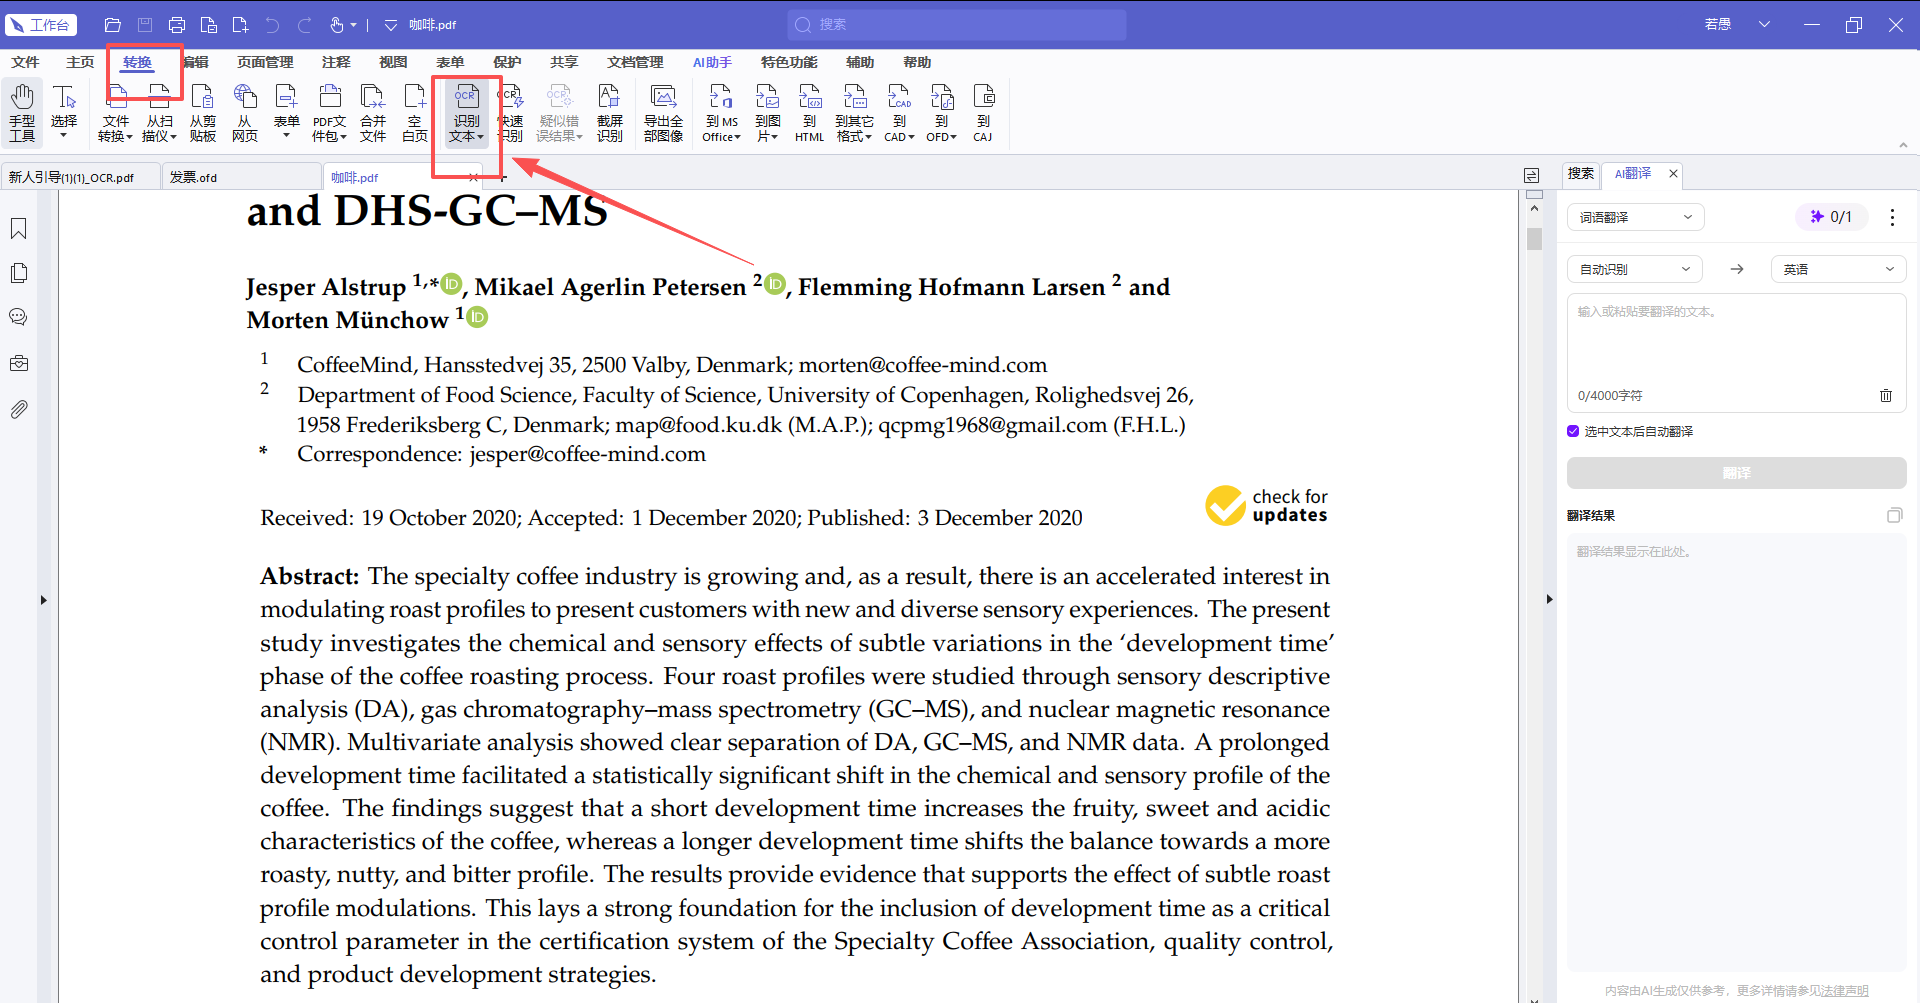
第2步,输出选可编辑文本:确认输出类型和页面范围,开始识别。
第3步,抽查识别结果:随机拖选几段看能不能选中,重点核数字、单位、人名。
第4步,转PowerPoint:「转换」→「到MS Office」→「到PowerPoint」,设好页面范围导出。

第5步,打开确认可编辑:用PowerPoint打开,点一句话看能不能进编辑态,能改才算走通。
3. Adobe Acrobat:OCR和导出都齐全,代价是订阅
它的流程是标准的:先「扫描和OCR」→「识别文本」→「在本文件中」,把文字层补进去,再走「导出PDF」选PowerPoint。识别质量属于第一梯队,外文和多语言混排尤其稳。问题是订阅制,价格不低,而且它的OCR对中文的识别率取决于原图质量,扫糊了一样白搭。如果你公司本来就有订阅,这条路是最完整的。
第1步,先做识别:「扫描和OCR」→「识别文本」→「在本文件中」。
第2步,检查文字层:识别完拖选一段文字,能选中说明成功。
第3步,导出成PowerPoint:「导出PDF」→「Microsoft PowerPoint 演示文稿」→ 设置 → 导出。
4. Wondershare PDFelement:先识别后转换,路径短
桌面客户端,本地跑不上传。思路和第2款一样:在软件里对扫描页做识别,生成文字层后再「转换」→「到 PowerPoint」。它的OCR界面做得比较直观,能选识别范围和语言,中文效果尚可。缺点是装客户端,部分高级功能要付费,原图拍歪拍糊时识别率会明显下降。
第1步,打开扫描件进OCR:在转换或识别功能区里选文字识别。
第2步,选语言和范围后识别:中文材料记得选中文,别让它默认按英文认。
第3步,识别完再转PowerPoint:确认能选中文字了,走「转换」→「到 PowerPoint」导出。

5. Smallpdf:在线OCR,方便但要把文件传上去
网页上有OCR工具,上传扫描件、识别、下载带文字层的PDF,再拿去转PPT。好处是不用装软件、不挑系统;代价是文件要过它的服务器,合同、证照、内部讲义一律别传。免费版有次数和大小限制,几十兆的扫描件容易被卡。识别质量对清晰的印刷体够用,带水印或手写批注的文件效果一般。
第1步,进站点选OCR工具:上传扫描件。
第2步,选识别语言后开始:中文材料选中文。
第3步,下载后再转PPT:拿到带文字层的PDF,再回到转换工具转一次。
6. iLovePDF:同样是在线识别,适合零散文件
和上一款一个路数:上传、识别、下载,再转换。它的优势是能一次挂多个文件排队,手上有一堆零散扫描件时比较顺手。限制同样按文件大小和任务数算,具体以官网为准。涉密文件不建议用,这是所有在线OCR绕不开的问题,不是它一家的毛病。
第1步,进站点选OCR:可添加多个文件。
第2步,设置语言后识别:中文选中文,识别完下载。
第3步,转成PPT并检查:下载带文字层的PDF后再转,打开确认文字能编辑。
7. Google Docs:零成本,顺手把OCR做了
这一招很多人不知道:把扫描的PDF上传到Google云端硬盘,用Google Docs打开,它会在打开过程中自动做一次文字识别,打开后下面就是可选中的文本,复制出来整理一下即可。完全免费,不用装任何东西。缺点很明显:复杂版面会乱成一团,表格基本保不住,页数多的文件打开很慢,而且文件要上传到谷歌,涉密材料绝对不能用。
第1步,上传到云端硬盘:把扫描件传上去。
第2步,用Docs打开:右键选择用文档方式打开,等它自动识别。
第3步,复制内容自己排版:识别结果直接贴进PPT重排,比转完再修更快。
扫描件怎么走最省事:本地优先,在线兜底
文件涉密、页数多、要求能改:第2款,识别加转换在一个软件里跑完,全程本地,这是我最常用的一条路线。公司已有订阅:第3款,识别质量最稳。想装个客户端慢慢折腾:第4款。偶尔一次、文件不敏感、不想装东西:第5款或第6款,先在线识别再转。临时应急、只有几页、对版面没要求:第7款,零成本但排版要自己重来。
至于第1款,它对扫描件帮不上忙——没有OCR就是没有,转出来必然是整页图。但反过来,如果你的文件本来就是文字版,它反而是最省事的那个:本地转、不上传、注册用户免费前5页。所以动手前那一下拖选,真的值得花三秒钟。
