
 免费下载

 2026-11-15 17:37:30

扫描件转Word是最容易翻车的一类:普通转换器碰上去,给你的不是文字,是一堆图片拼起来的版面,一个字都改不了。原因很简单,扫描件里根本没有文字层,得靠OCR先认字。这篇就讲这类文件怎么转,哪些工具真带识别能力,认错的字怎么补。
一、福昕PDF阅读器
它自带的PDF转Word走【转换】选项卡,首次使用会加载转换组件,普通扫描件它也能处理,只是识别质量取决于扫描清晰度。我的经验是:扫描时歪了、糊了,转出来错字就多,先拿一份试,效果行再批量来。日常把纸质材料录成电子稿够用。
打开扫描件:启动福昕PDF阅读器 → 【文件】→【打开】
进入转换:【转换】→【PDF转Word】
加载组件:首次点会提示安装转换组件 → 等装完
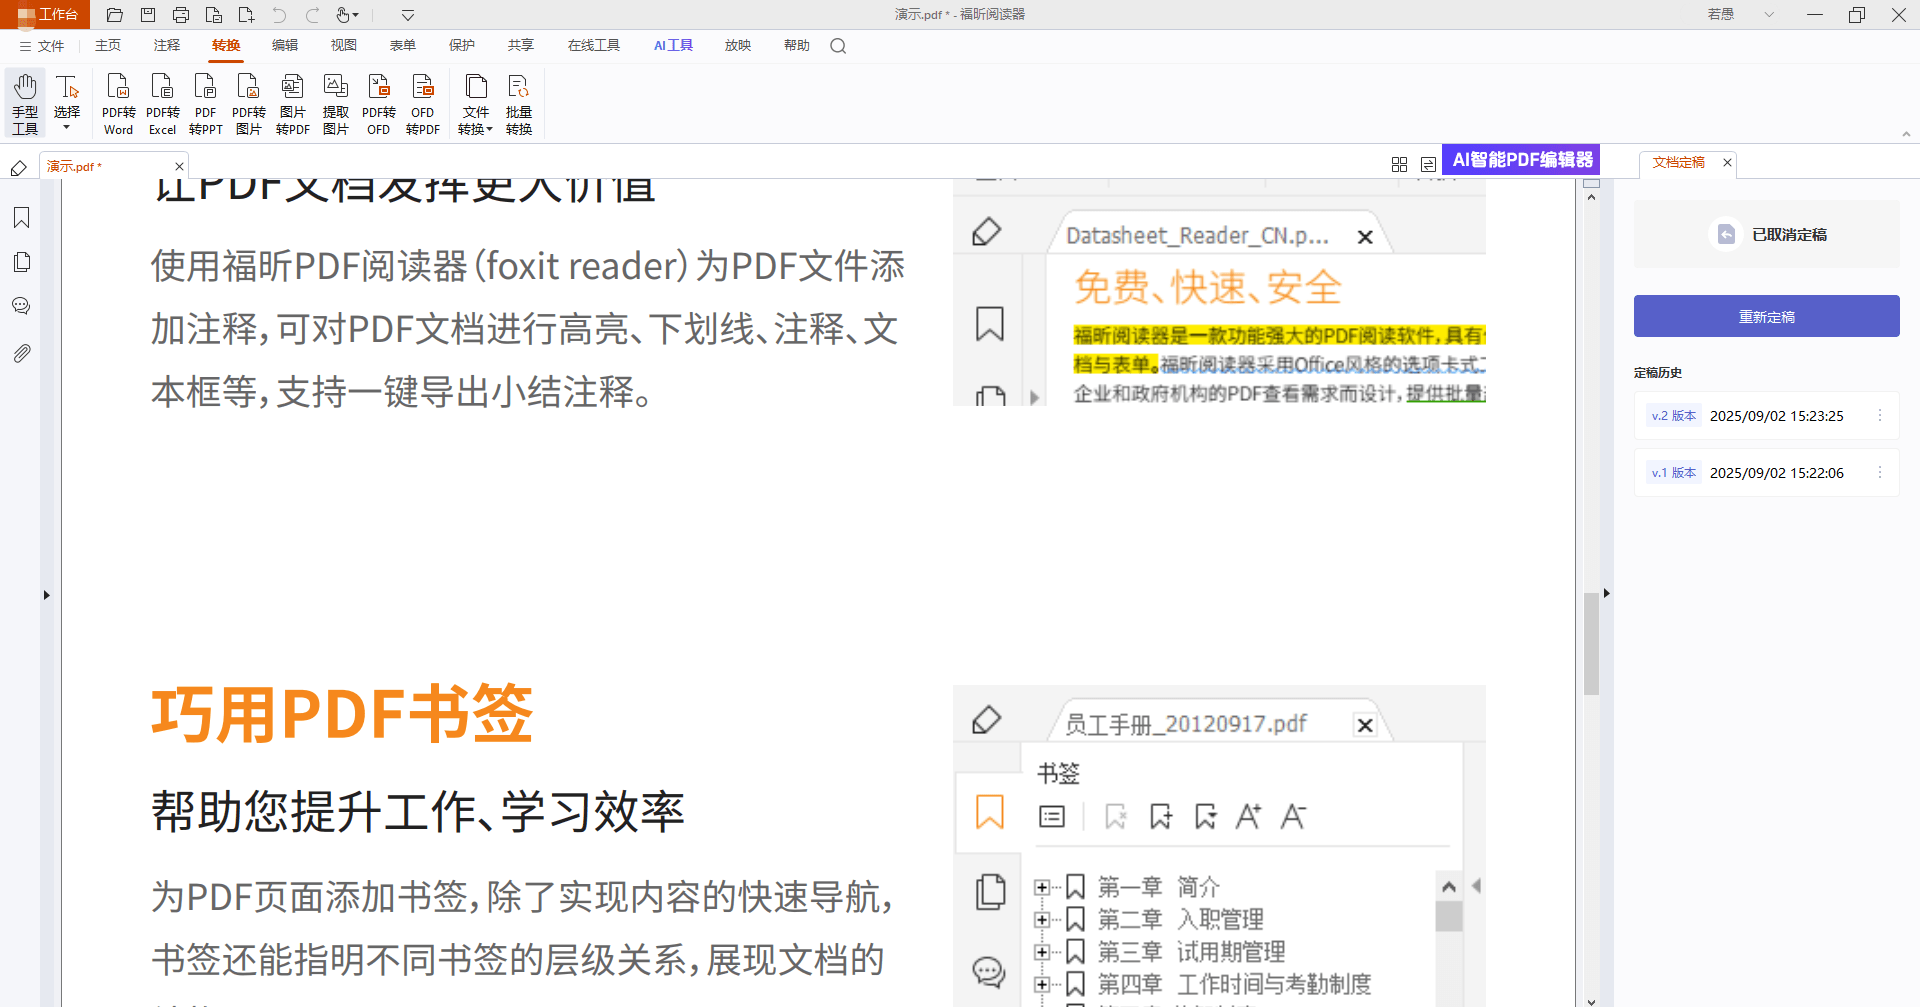
本地转换:选输出目录 → 点开始转换 → 全程不联网
检查文字:打开docx看是不是可编辑文字 → 不是的话说明识别没成功
校对:对着原扫描件通读一遍 → 数字和专有名词重点核对
二、福昕PDF转Word
正经的扫描件批量活,交给它更靠谱。它的识别对倾斜、带底纹的扫描页容忍度高,批量转几十份能一次性识别并输出成多份docx,输出的Word还保留原版面,不用大改。缺点是付费,属于"用得多了才划算"的类型。
启动:打开福昕PDF转Word → 选【PDF转Word】
添加文件:批量拖入扫描件PDF
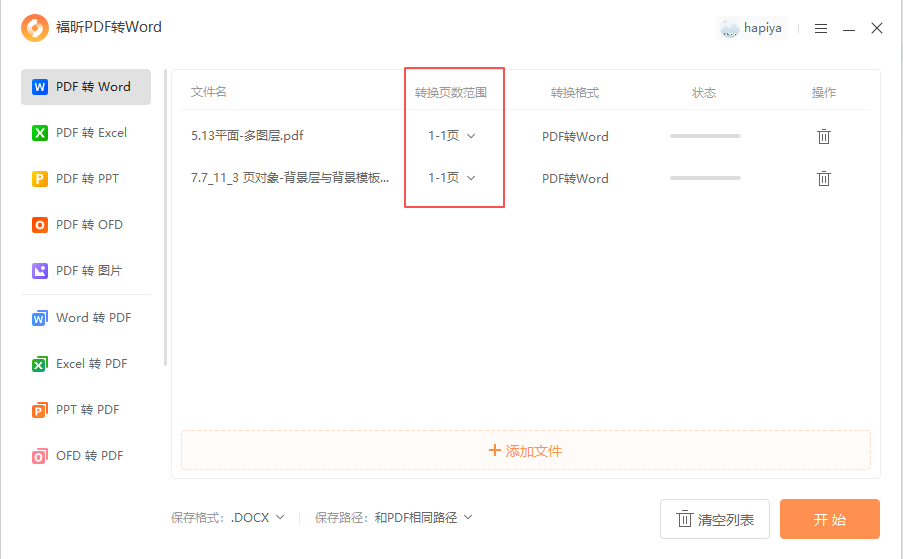
开识别:勾选OCR文字识别选项 → 选中文识别语言
设输出:指定文件夹 → 确认输出为docx
开始并验收:任务跑完后打开抽查 → 识别错的词用Word查找替换批量修
三、iLovePDF
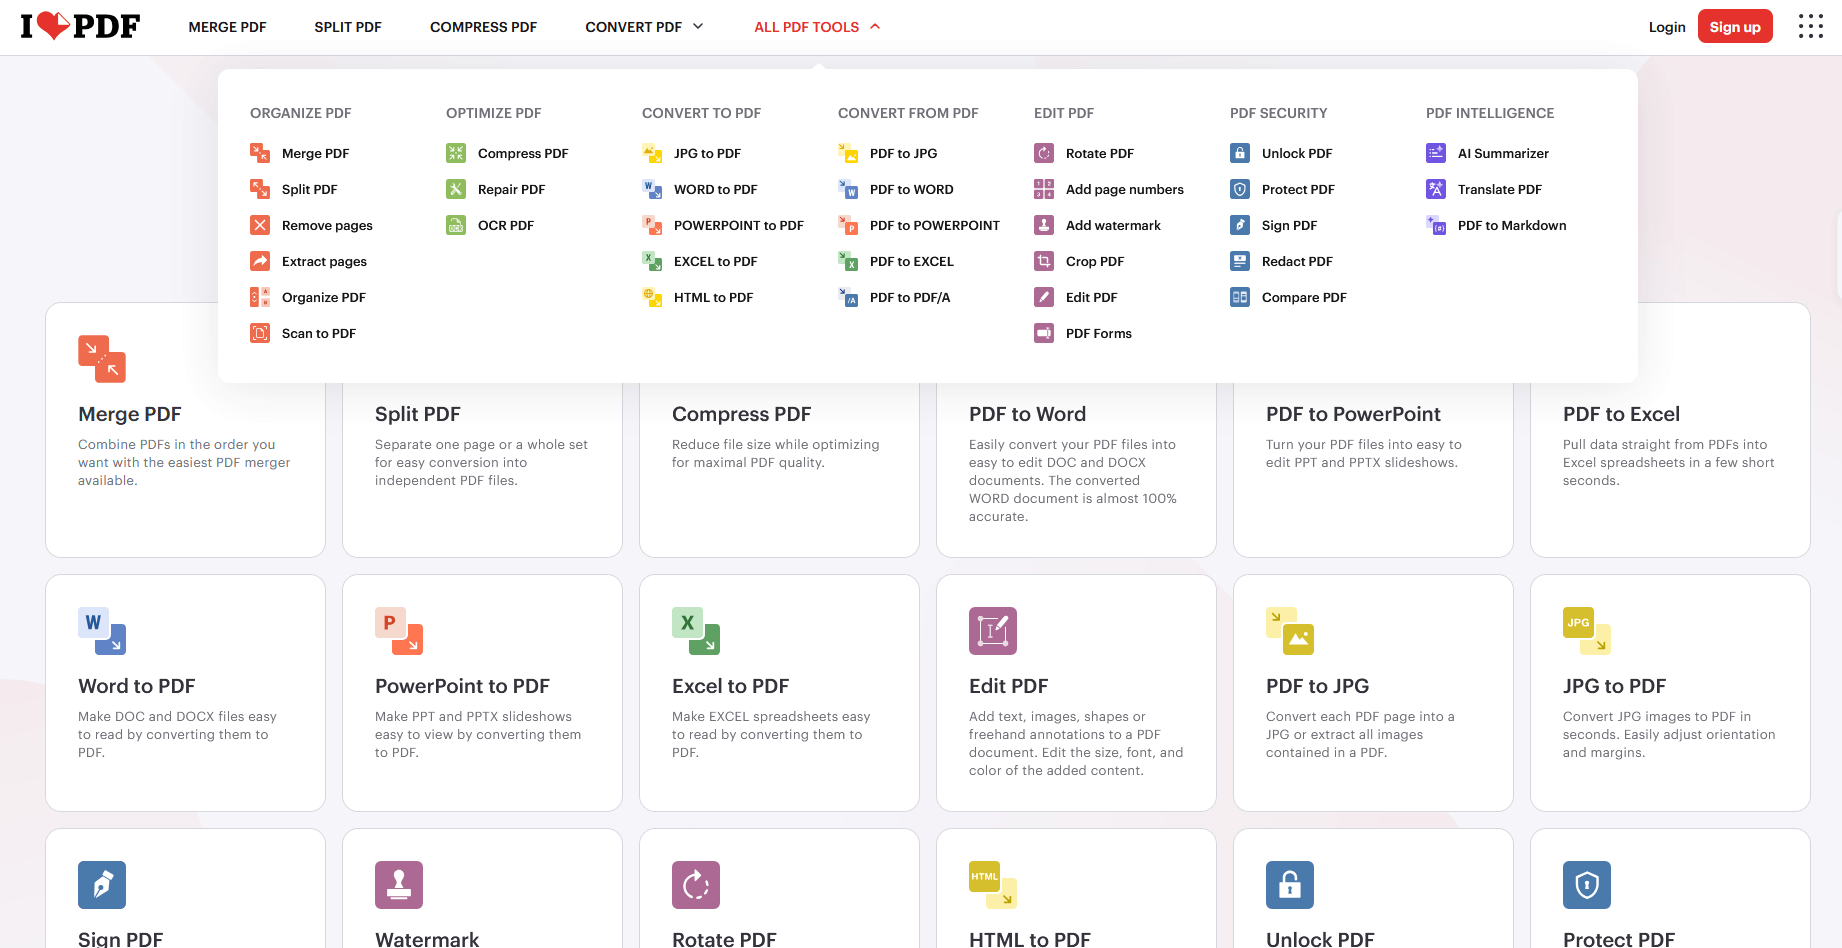
在线方案里做OCR最出名的一家,扫描件上传后勾上OCR,选识别语言,转出来的Word文字基本能编辑。它对低质量扫描件的识别率在免费工具里算高的,代价是处理时间比普通转换长很多。
四、Smallpdf
转换时自动启用文字识别,扫描件也能出可编辑文档。它的识别偏快,对清晰的打印体效果好,手写体和五号以下的小字容易出错。适合规范的扫描件,比如打印出来的合同、发票。
五、Adobe Acrobat
OCR 这一块的老大,扫描件转Word的识别准确率和版面还原都是第一梯队,中文混排、多栏排版、表格里的数字都能认准,还支持大批量处理。缺点依然是价格,个人用户很少为这个单独订阅。
六、Nitro PDF
桌面转换里的实力派,扫描件识别支持多语言,长文档跑完不会中途断掉。它对双栏排版的还原比较好,学术论文类的扫描件转出来阅读顺序不会串。买断授权,界面英文。
七、Sejda PDF
在线工具,带OCR但免费版限制较严,单文件不超过50兆、100页以内,适合转几页的关键材料。好处是能先预览识别结果再下载,不满意调整参数重来。
还有个容易被忽略的点:扫描件如果本身是彩色的,转Word后文字会带上底纹,看着像蒙了层灰。处理办法是扫描时直接选黑白或灰度模式,或者转之前用修图工具把对比度拉高。这一小步能让识别率明显上一个台阶,我试过同一份文件,调过对比度的版本错字少了一半。
扫描件转Word,前面的功夫比工具更重要:扫描时摆正、光线均匀、分辨率200DPI起步,识别准确率能差出一大截。转完千万别直接用,数字、金额、人名一定要对一遍原文,我见过把3看成8的报价单,那可不是小事。
