

帮朋友的字幕组翻过一集纪录片,四十分钟,一千多条字幕。他之前把整个 SRT 丢进翻译网站,出来的文件时间轴全丢了,播放器直接读不出来,一晚上的活白干。字幕文件的特殊性在于:它是带时间码的纯文本,格式错一个符号就废。
这篇说说我自己翻字幕的流程,用到的福昕翻译大师和海外工具,思路都是把时间轴和文本分开处理。
福昕翻译大师:只翻文本,时间轴自己护住
1. 用记事本打开 SRT,把序号、时间码、空行全留着,只把台词那一行选中复制。
2. 打开客户端的「文字翻译」,把台词按段落粘进去,源语言选英文,目标语言选中文。
3. 译完把译文按行贴回原来的位置,序号和时间码一个字都别动,存成 UTF-8。
4. 用播放器从头拖一遍,字幕跟画面对不上的地方再单独调时间码。
这个笨办法慢一点,但不会破坏格式,字幕组里很多人都是这么干的。它还能配合划词翻译,遇到俚语单独划一下看释义,比整段猜准。
一次粘二三十条比较合适,粘太多容易错行。翻完对一遍条数,一千条出稿前少了几条,找起来特别费劲。
遇到带特效的 ASS 字幕,翻译前先备份一份原文件。特效代码和时间码混在一起,改错一个符号整段就不显示了。
福昕翻译在线:网页版粘一段翻一段
1. 打开 fanyi.pdf365.cn,进文字翻译,一次粘二十到三十条台词。
2. 翻完复制回字幕文件,接着粘下一批,分段处理不容易乱。
3. 团队分工时按时间段分,一人负责十分钟,最后合并。
网页版的好处是不用装,字幕组几个人分工也方便,一人一段各自翻完再合。合的时候注意别把行数弄错,最好用带行号的编辑器。
DeepL:口语台词翻得最自然
日常对话和语气词处理得好,翻出来的中文字幕读着像人说的话,不会满屏书面语。
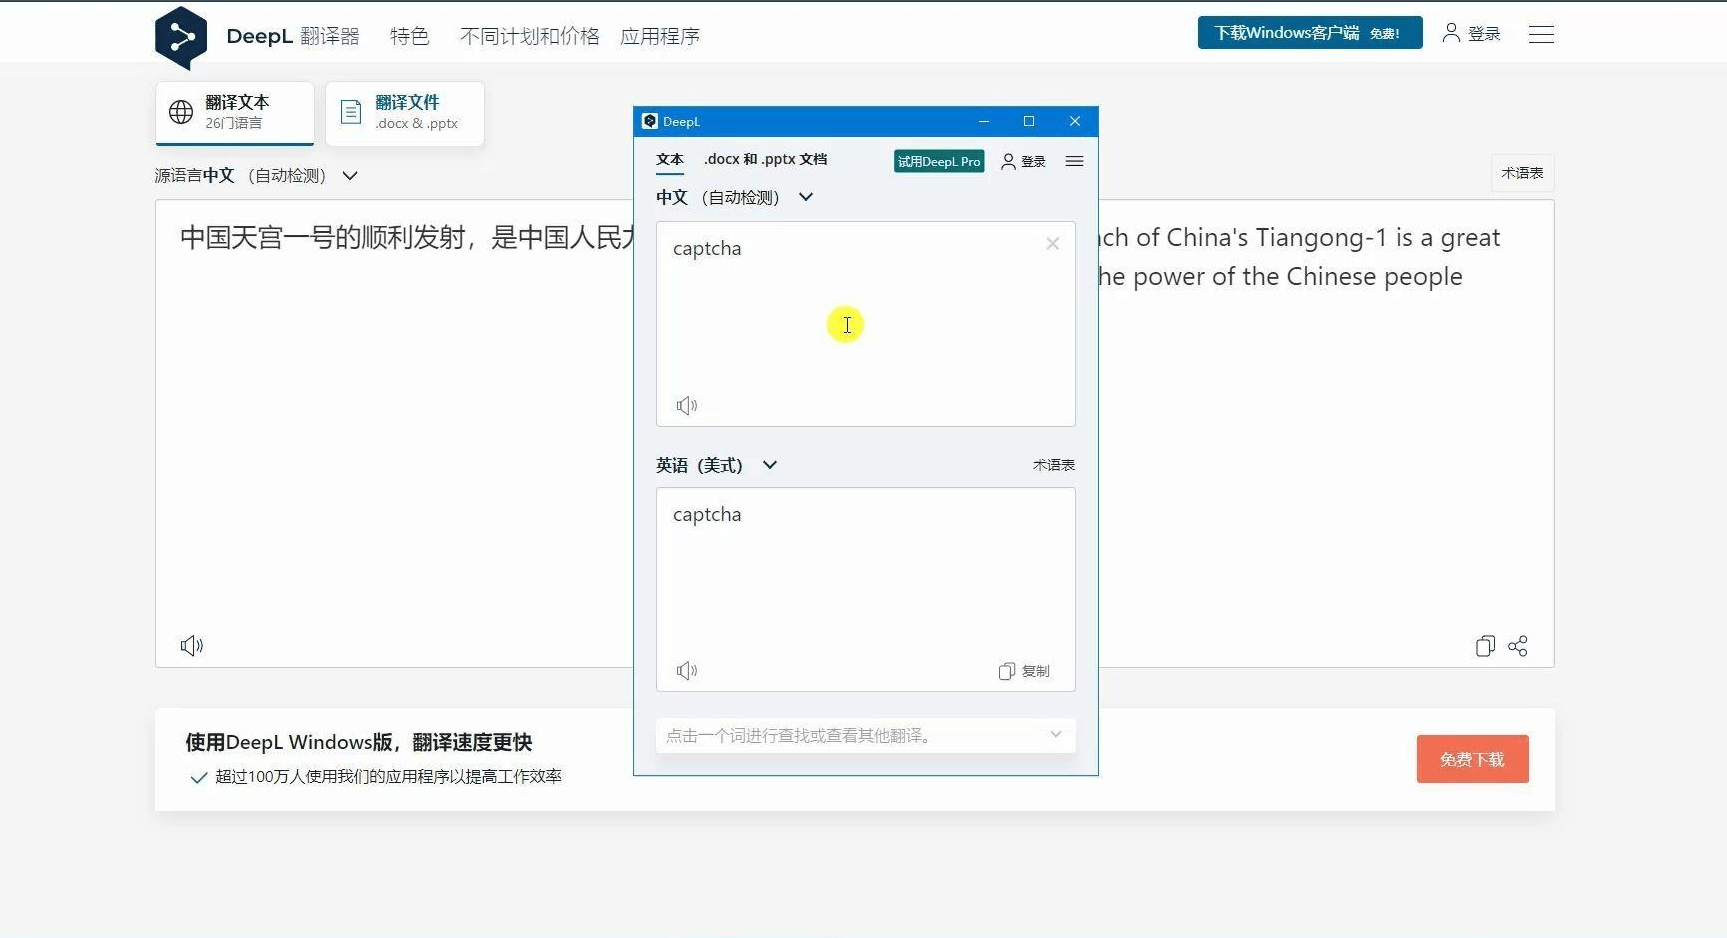
一次粘太多会被限字数,按场景分段粘比较稳。它对梗的处理一般,网络梗得自己改。
Subtitle Edit:免费的字幕编辑器
开源软件,能直接打开 SRT 和 ASS,内置翻译接口,时间轴和文本分开处理,不会互相污染。
还能批量调整时长、合并断行,做字幕的活它基本都能干。界面偏工程师风格,第一次用要摸索半小时。
Google 翻译:查俚语和口头禅
遇到听不懂的俚语丢进去,看它给什么,再结合画面判断,比瞎猜强。
整段台词它翻得偏书面,字幕要口语感还得自己改。免费、快,当速查工具用正好。
Happy Scribe:自动转写加翻译
有视频文件的话可以直接上传,自动识别语音生成字幕再翻译,省掉手打的时间,英文听写准确率不错。
按时长收费,价格不算低,适合商单。口音重的素材识别率会掉,交付前要通读。
ChatGPT:统一角色说话的口吻
把几个角色的台词风格告诉它,让它按人物统一语气,翻出来的字幕不会所有人一个腔调。
它不懂时间码,只能处理文本。长对话一次给太多会串行,按场次分开更稳。
Aegisub:调轴和样式的老工具
字幕组常用,时间轴对齐、样式设置、特效字幕都能做,跟翻译配合着用很顺。
学习成本高,只是翻个字幕用不上它。做双语字幕和特效字幕的时候才轮到它出场。
字幕翻完一定要通读一遍,把「的」太多、句子太长的地方改短。观众看字幕的时间只有两三秒,一行超过十六个字就得拆,不然根本来不及读,翻得再准也白搭。
字幕交付前建议在两种播放器里各放一遍,有些播放器对编码敏感,UTF-8 存不对就满屏乱码,观众第一眼就关了。

